PostgreSQL:pgvector 距离度量与运算符
距离度量的重要性
pgvector 提供 6 种距离度量方式,选择合适的距离度量方式对于数据库的检索效果有着重大影响。
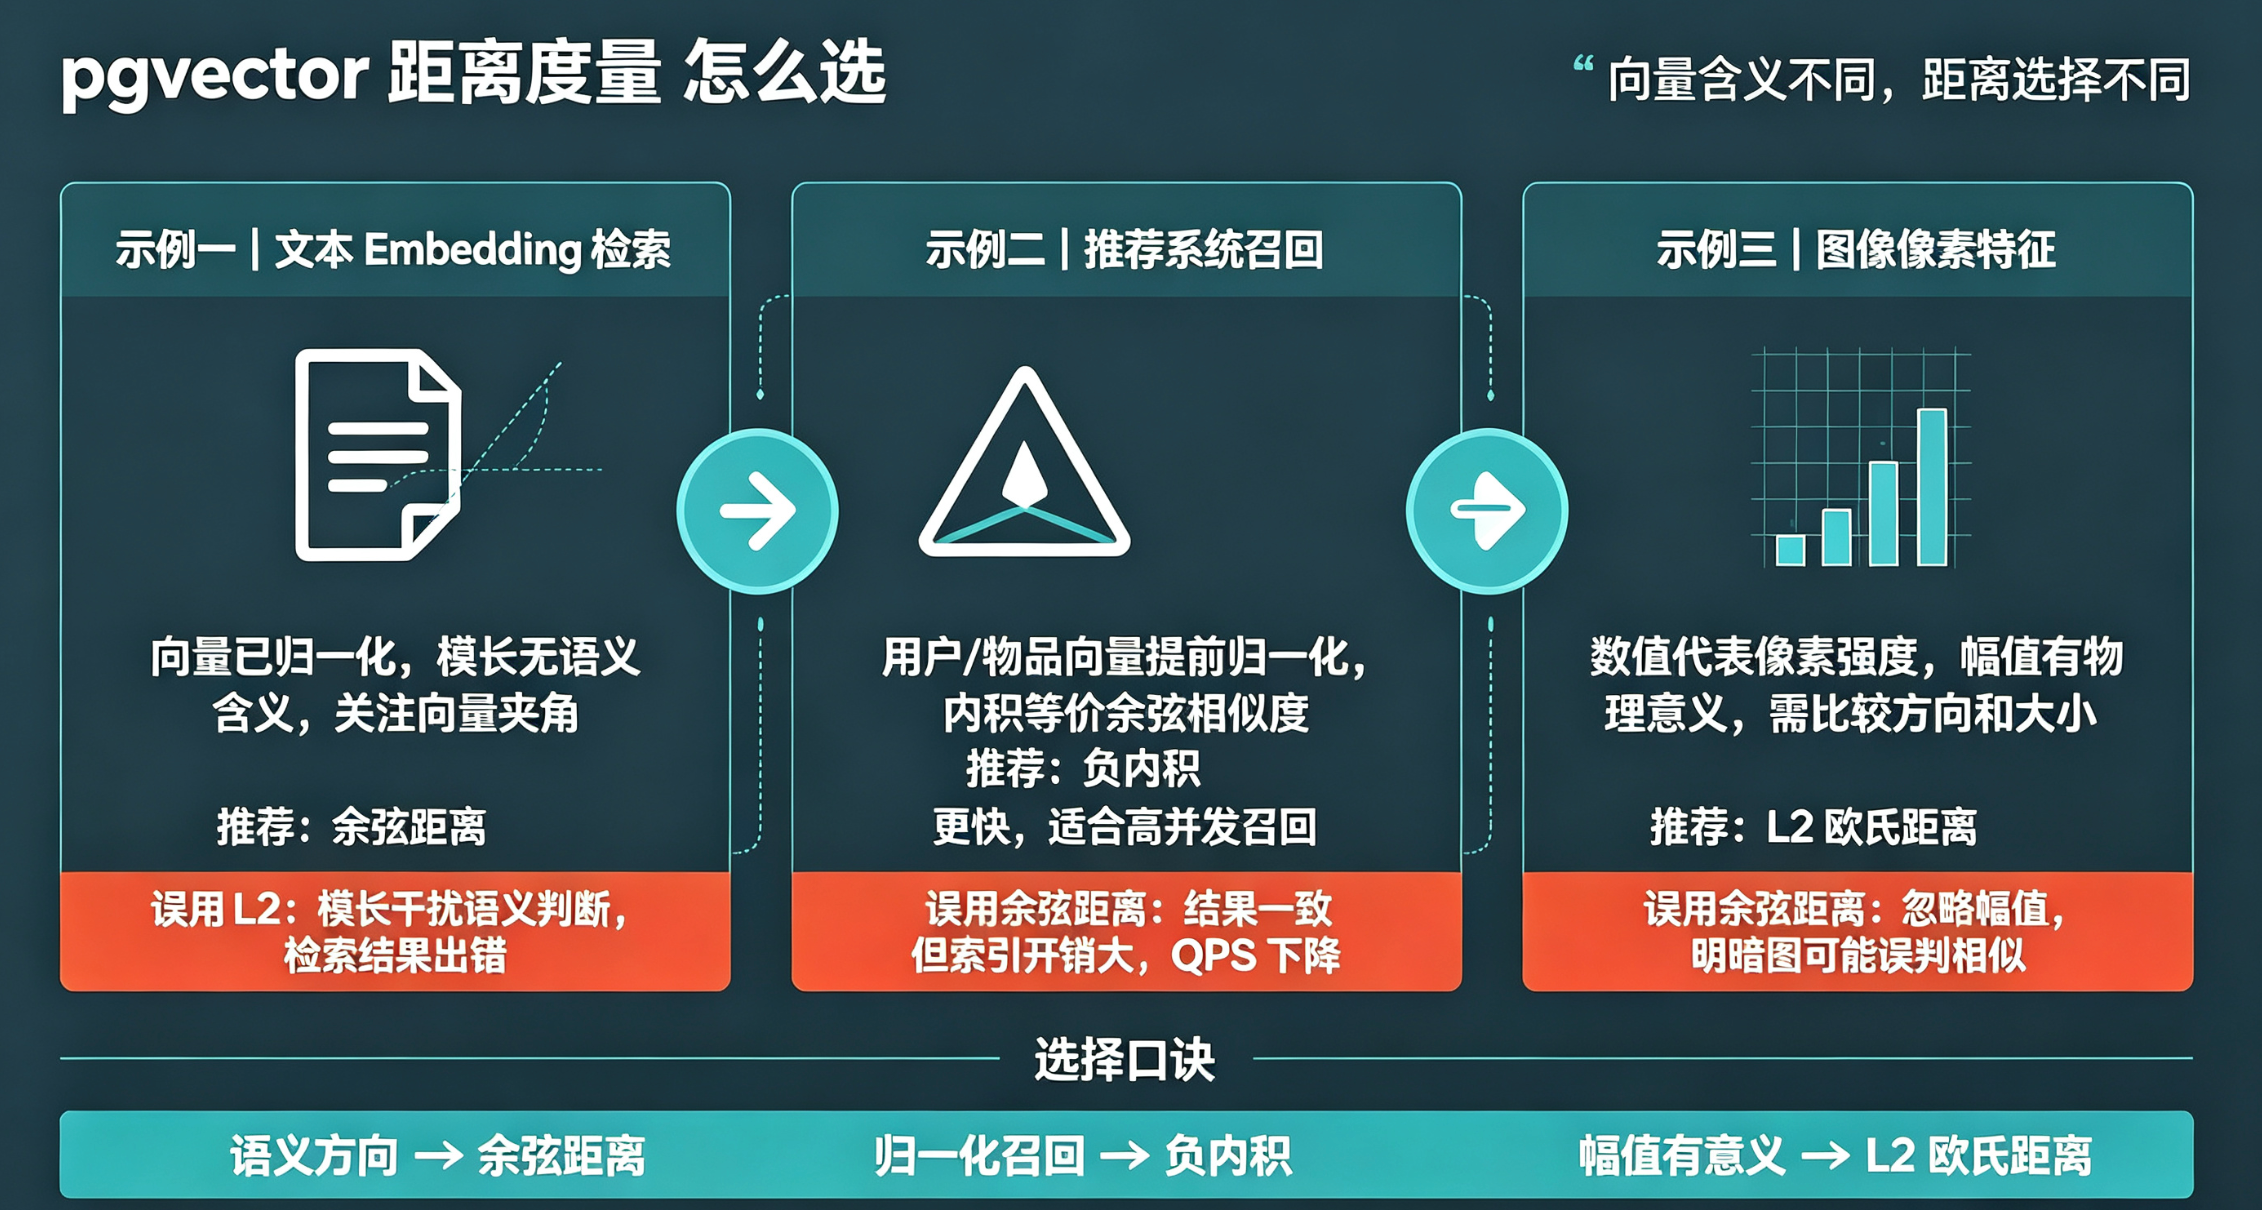
选错距离度量方式,不会报错,但会让"最相似"的结果排错位置 —— 而且很难察觉。举 3 个例子说明选择合适距离度量方式的重要性。
示例一:文本 Embedding 检索
用大模型 embedding 做知识库检索,向量已经做过长度归一化,文本向量的模长没有语义含义,只需要比较向量夹角,所以选择余弦距离度量方式最为合适。
如果误用 L2 距离,模长差异会干扰语义相似度判断,导致检索结果出错。
示例二:推荐系统,归一化用户 / 物品向量
推荐系统在召回阶段,用户向量和物品向量都提前归一化,用内积排序做推荐。内积等价余弦相似度,计算更快,索引 vector_ip_ops 性能更好。
如果误用余弦距离,虽然数学结果一致,但索引开销更大,QPS 下降。
示例三:图像像素特征向量
低维图像手工特征,向量数值代表像素强度,幅值本身有物理意义,L2 距离同时考虑向量方向和幅值差异,两个特征向量整体数值越接近,距离越小。
如果误用余弦距离,会忽略幅值信息。
距离运算符总览
pgvector 提供六种距离运算符:
| 运算符 | 名称 | 计算的距离 | 返回含义 | 排序方向 | 适用类型 |
|---|---|---|---|---|---|
<-> | L2 距离 | 欧氏距离 | 距离(越小越相似) | ASC | vector / halfvec / sparsevec |
<#> | 内积 | 负内积 | 负内积(越负越相似) | ASC | vector / halfvec / sparsevec |
<=> | 余弦距离 | 1 - 余弦相似度 | 距离(越小越相似) | ASC | vector / halfvec / sparsevec |
<+> | L1 距离 | 曼哈顿 / 出租车距离 | 距离(越小越相似) | ASC | vector / halfvec / sparsevec |
<~> | 汉明距离 | 不同位数 | 距离(越小越相似) | ASC | bit |
<%> | 杰卡德距离 | 1 - 杰卡德相似度 | 距离(越小越相似) | ASC | bit |
距离度量介绍
L2 距离(<->)
- 对向量长度 / 幅度敏感:两个向量方向一致但长度差很多时,L2 也会给出较大距离
- 适合原始特征 / 数值空间
- 不适合长度差异大的文本嵌入:长文档的嵌入模长天然更大
余弦距离(<=>)
- 只看方向、不看长度,值域 0(方向完全相同)到 2(完全相反)
- 文本语义检索的默认选择,和大多数嵌入模型的训练假设一致
- 注意:零向量不参与余弦计算
内积(<#>)
- 返回负内积;
ORDER BY embedding <#> query默认 ASC,把"最大内积"排最前 - 适合推荐 / 打分场景,内积比余弦更合适
L1 距离(<+>)
- 曼哈顿距离,相比 L2 不平方,对离群点 / 异常值更稳健
- 适合某些稀疏或噪声较大的特征比较
汉明距离(<~>)/ 杰卡德距离(<%>)
- 仅
bit类型可用 - 汉明:两个等长的二进制串中"不同位的个数"
- 杰卡德:
1 - 交集/并集,衡量两个集合的不相似度 - 适合已做二值量化 / 哈希的特征(如图像哈希、大规模粗召回)
推荐选择
| 场景 | 运算符 | 类型 |
|---|---|---|
| 文本语义、用现成嵌入模型 | <=> 余弦 | vector / halfvec / sparsevec |
| 模型已单位归一化(如 OpenAI) | <#> 内积(最快) | vector / halfvec / sparsevec |
| 图像 / 像素 / 数值原始特征 | <-> L2 | vector / halfvec / sparsevec |
| 特征含离群点、要更稳健 | <+> L1 | vector / halfvec / sparsevec |
| 已二值化 / 哈希特征 | <~> 汉明 / <%> 杰卡德 | bit |
| 推荐系统 dot-product 打分 | <#> 内积 | vector / halfvec / sparsevec |
小结
- pgvector 六种距离运算符:L2
<->、内积<#>、余弦<=>、L1<+>(稠密三类型通用)+ 汉明<~>、杰卡德<%>(仅bit) - 核心原则两条:
- 运算符 ↔ 嵌入模型的距离假设必须一致(否则排序悄悄出错)
- 索引 operator class ↔ 查询运算符必须一致(否则退化全表扫描)
- 归一化后 余弦 ≡ 内积排序,内积计算更快,优先用
<#> - 内积返回负值,记得用默认 ASC;想展示真实值就
* -1