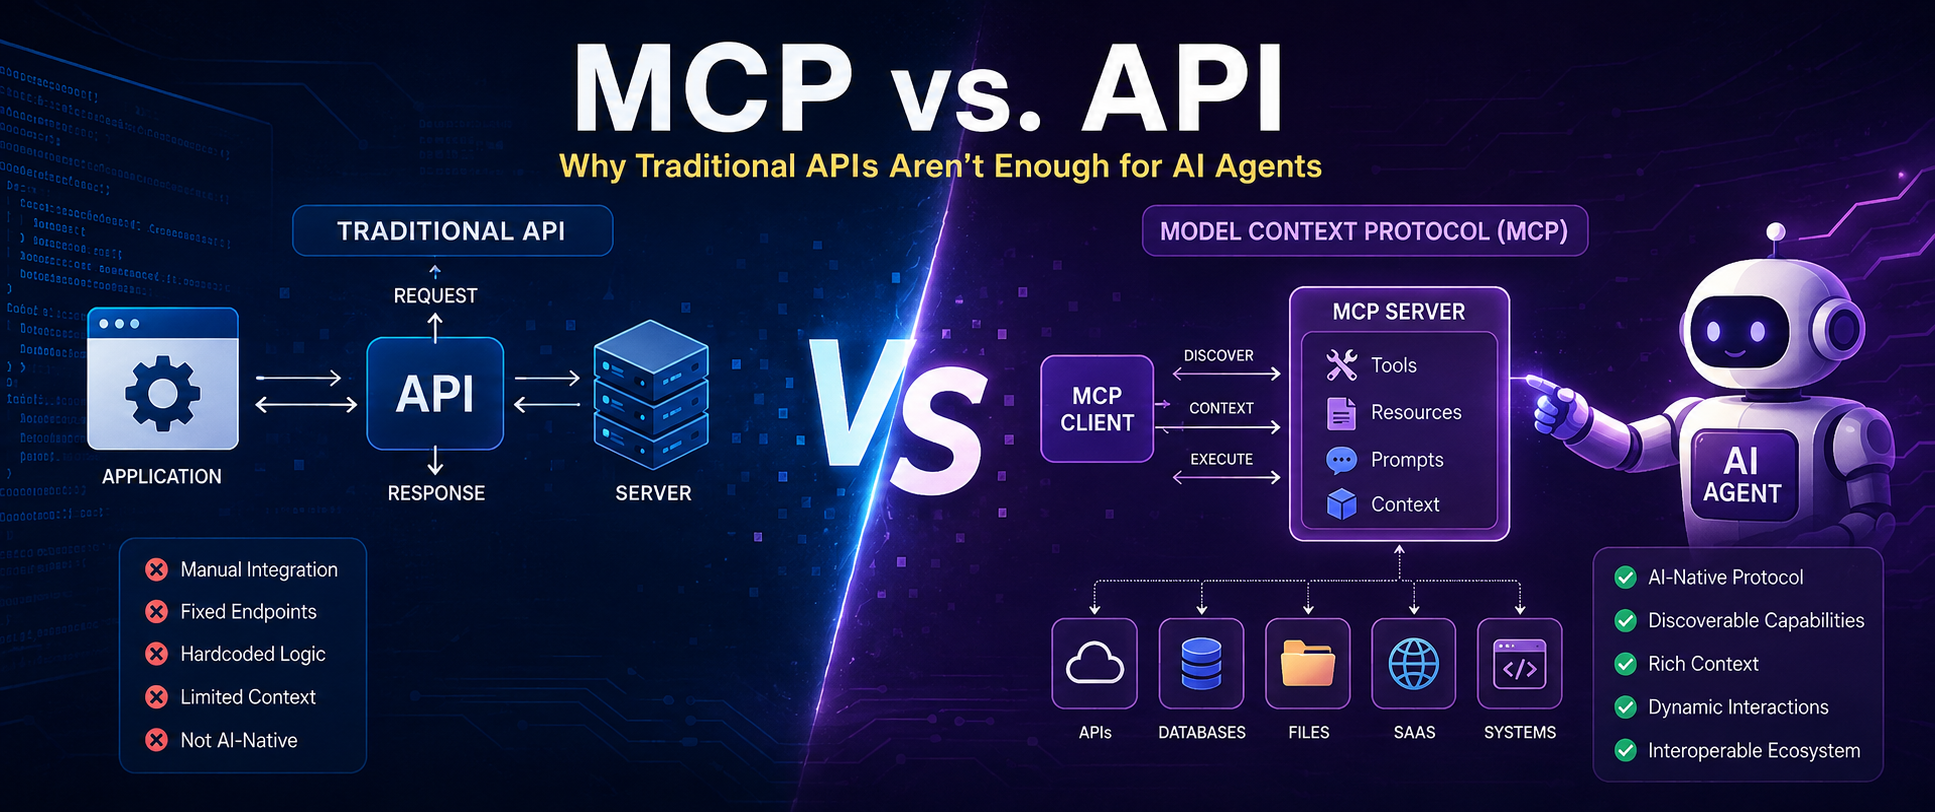
MCP vs. API:为什么传统 API 撑不起 AI Agent
本文为 dev.to 上的文章,原文地址: https://dev.to/cpathirage/mcp-vs-api-why-traditional-apis-arent-enough-for-ai-agents-go2 。
API 没有坏。
几十年来,它支撑着互联网、移动应用、SaaS 平台和分布式系统。
但有些东西变了。
软件 API 的消费方,不再总是开发者写的另一段软件。
基于词袋的概率检索模型 BM25 详解
BM25(Best Matching 25)是基于词袋的概率检索模型,目前是搜索引擎、ES/OpenSearch 全文检索默认的相关性打分算法,用来计算查询词 Q 和文档 D 的相关性分数。
Nori:面向表格回归的上下文学习模型
Nori 是一系列面向表格数据回归的轻量级模型,由 Synthefy 推出。它的核心思路是上下文学习(In-Context Learning):无需传统意义上的参数训练,只要把一小段“已知样本(上下文)”喂给模型,它就能对新的查询行直接给出预测。
PostgreSQL:pgvector 扩展存储与检索手写数字图像(MNIST 数据集)
本文是关于 PostgreSQL pgvector 扩展的一个示例,使用 hafvec 向量类型存储和检索手写数字图像(MNIST 数据集)。
目标:向量化存储 60,000 张训练图像,并用 10,000 张测试图像进行检索,统计检索准确率。